Greencell USV an Synology: Wenn NAS und USV nicht miteinander reden

Heute verabschieden wir uns von meiner USV. Meine alte APC Back-UPS 700 hat nach gut sechs Jahren mit einem piependen Dauerton den Dienst quittiert. Weil mein Homelab inzwischen gewachsen ist, sollte die nächste USV mehr Akku und mehr Ausgabeleistung in Watt mitbringen.
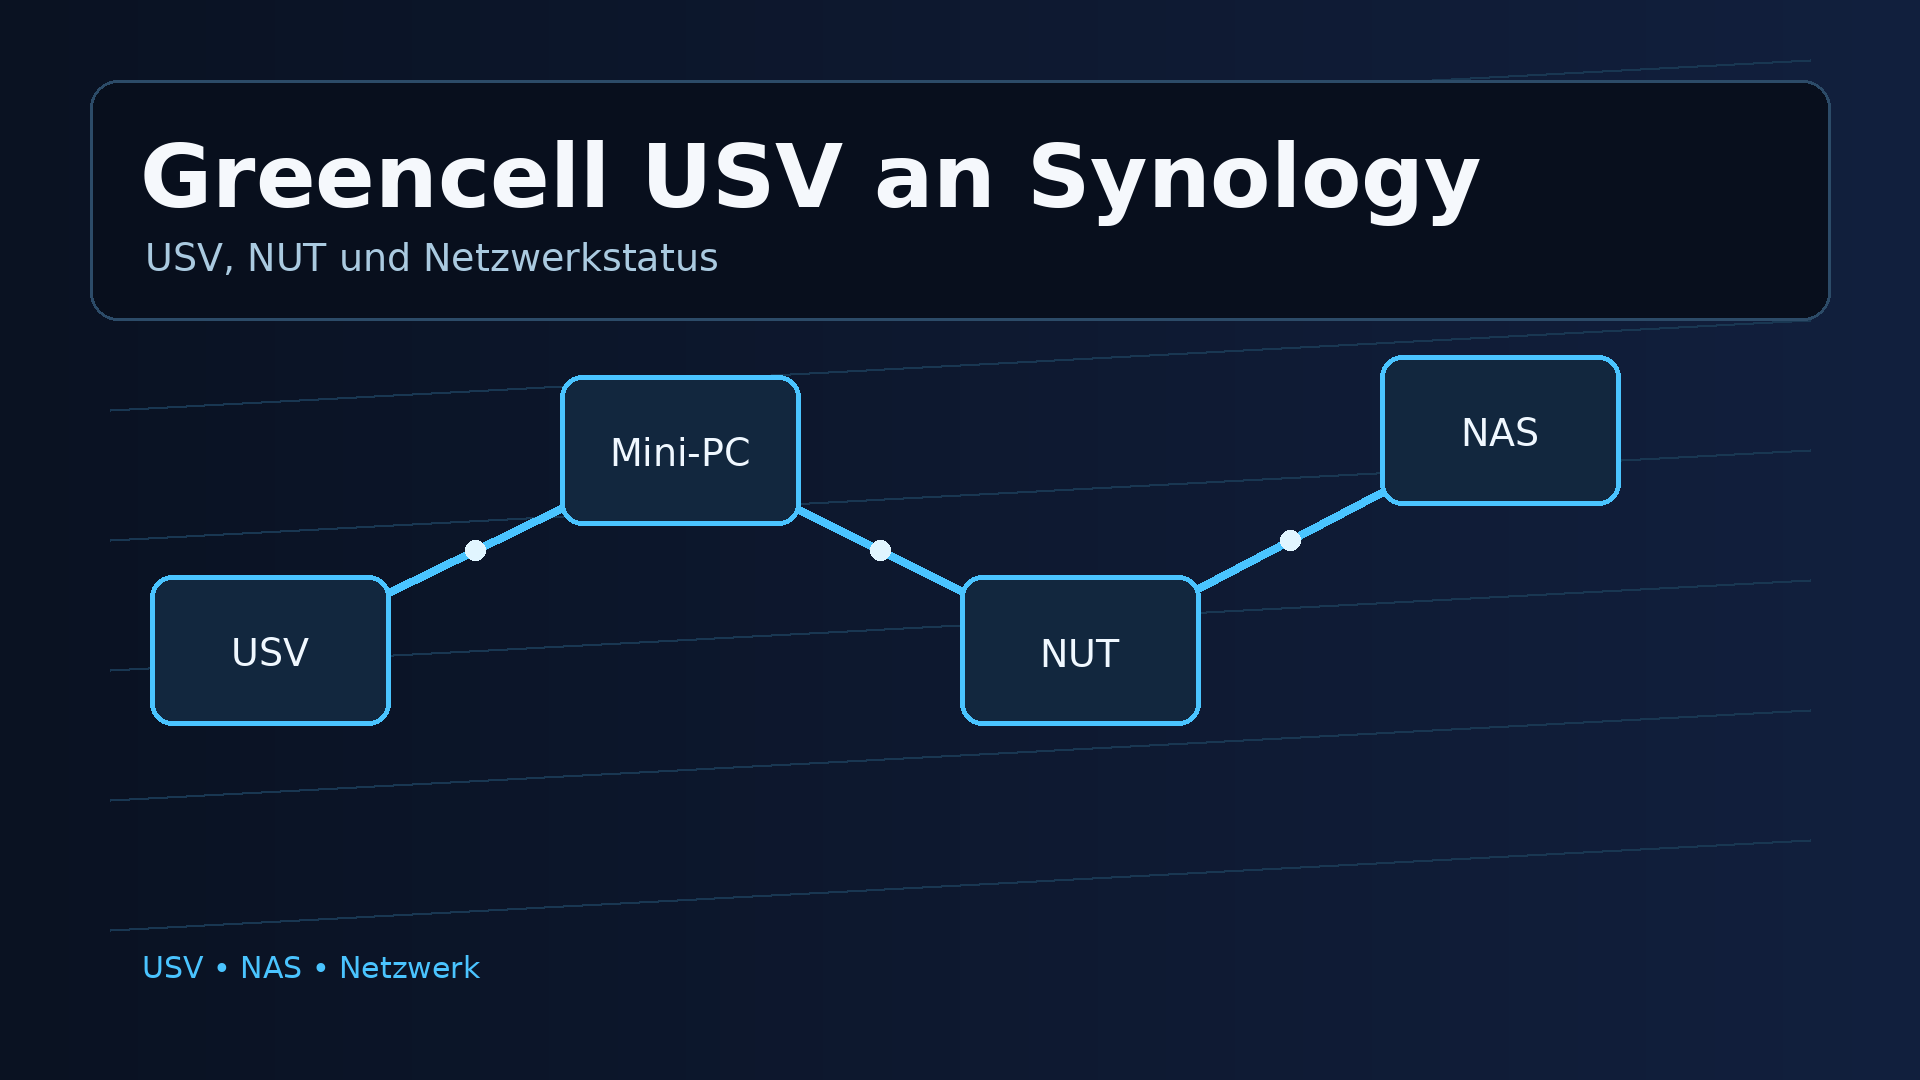
In diesem Artikel zeige ich, wie ich die neue Green Cell USV 2000VA, 1200W, Hersteller-Modell UPS05, trotzdem mit meinem NAS zusammenbringe. Das NAS erkennt das Gerät zwar, liest aber kaum brauchbare Werte aus. Die Lösung ist ein kleiner Umweg: Die USV hängt per USB an einem Mini-PC, ein NUT-Server in einem Docker-Container liest sie aus und stellt den Status über das Netzwerk bereit. Die Synology liest dann die Werte der USV per Netzwerk.
Nach den Schritten kennt die NAS den Zustand der USV wieder und kann sich rechtzeitig herunterfahren. Die Messwerte kannst du dir bei Bedarf zusätzlich in PeaNUT ansehen.
Warum die neue USV an der NAS fast nichts liefert
Die alte […]
Das Internet ist tot, oder?

Seit einiger Zeit habe ich das Gefühl, dass das Internet ein schlechterer Ort geworden ist. Nicht unbedingt lauter, nicht unbedingt langsamer, aber leer an den Stellen, an denen früher Menschen sichtbar waren. Vor zehn oder fünfzehn Jahren konnte ich mich durch kleine private Blogs klicken, in Foren mitlesen, in Kommentaren widersprechen und dabei nebenbei etwas lernen. Es war ein Netz aus vielen kleinen Stimmen, nicht immer klug, nicht immer schön, aber erkennbar von Menschen gemacht.
Ich erinnere mich an Abende, an denen ich einen Blogeintrag über ein Problem gelesen und über die Kommentare eine bessere Lösung gefunden habe. Ich habe selbst geschrieben, Fragen gestellt, Fehler korrigiert und Links zu anderen Seiten gesetzt. Heute schreibe ich weiterhin über Dinge wie mein GitHub-Backup mit Gickup und Forgejo oder lokale KI im Homelab. Ein Beitrag war früher oft nur der Anfang eines Gesprächs. Heute lande ich viel häufiger bei großen Medien, die längst zu […]

GitHub-Backup mit Gickup und Forgejo

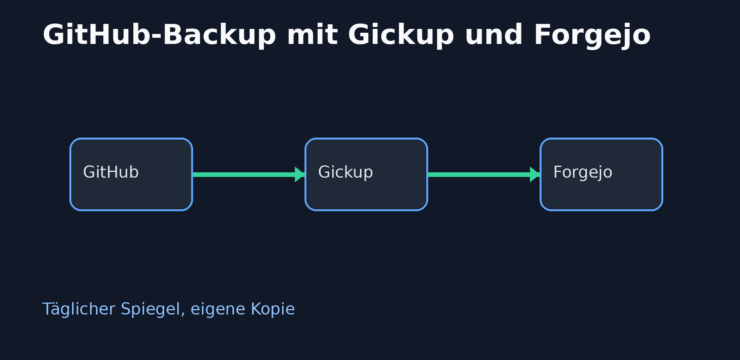
In meinem über Jahre gewachsenen GitHub-Konto codebude steckt ein ziemlich großer Teil meiner Arbeit. Rund 70 Repositories sind es inzwischen, öffentliche und private, darunter auch Forks. Du kennst das: Ein gehostetes Konto ist bequem, aber die Kopie liegt trotzdem bei jemand anderem.
Mein Ziel ist deshalb überschaubar und konkret: Alle Repositories sollen einmal täglich automatisch auf meine eigene, selbst gehostete Forgejo-Instanz gespiegelt werden. Nicht als händischer Export, den ich irgendwann vergesse, sondern als Routine, die auch dann läuft, wenn ich gerade andere Dinge im Kopf habe.
Damit liegt eine vollständige Kopie in meiner Hand, aus der ich jederzeit klonen kann, unabhängig davon, was mit meinem GitHub-Konto oder dem Dienst passiert. Das ist kein Schutz vor jedem denkbaren Datenverlust, aber es entfernt eine wichtige Abhängigkeit.
Im ersten Abschnitt kläre ich, warum ich diesen Umweg überhaupt gehe. Danach bauen wir den Ablauf Schritt für Schritt mit Gickup, Docker und Forgejo auf.
Warum ein eigenes Backup für […]

Wenn Docker schneller als das NAS ist

Am Morgen meldete mein Backup-Tool einen Fehler, und zwar bei allen GitHub-Repositories, die es in meine selbst gehostete Forgejo-Instanz spiegeln sollte. Im Log standen ERR pkt-line 3: EOF git=push und anschließend Exiting with status=1. Mein erster Verdacht fiel auf das Tool-Image, das ich kurz zuvor aktualisiert hatte. Plausibel, schnell gedacht und komplett daneben.
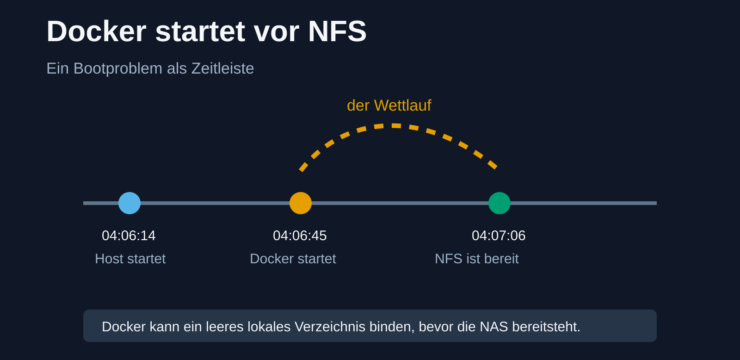
Die eigentliche Ursache lag eine Schicht tiefer. Forgejo speichert seine Repositories auf der NAS, die per NFS in den Container gemountet wird. Mein Docker-Host bootete um 04:06:14, der Forgejo-Container startete um 04:06:45. Die NFS-Mounts waren erst ab 04:07:06 aktiv, der letzte sogar erst um 04:07:16. Docker war also schneller als die NAS.
Das ist eine ungünstige Reihenfolge, weil Docker Bind-Mounts beim Containerstart auflöst und fehlende Quellverzeichnisse selbst anlegt. Existiert der Mountpunkt zu diesem Zeitpunkt nur als lokales Verzeichnis, bindet Docker genau dieses leere Verzeichnis ein. Wenn NFS später erscheint, sieht der Host zwar die echten Daten, der Container bleibt […]

llama.cpp in Docker unter WSL2 mit CUDA

In diesem Guide zeige ich dir, wie ich einen lokalen, OpenAI-kompatiblen llama-server in Docker unter WSL2 mit CUDA-Beschleunigung einrichte, und nehme dich dabei vom grundlegenden Aufbau bis zum ersten funktionierenden Request mit.
Am Ende läuft ein llama-server im Container, der über WSL2 die GPU nutzt, mit genau einem Slot, also -np 1, und mindestens 128k Kontext. Ich brauche diese Größe aus eigener Erfahrung, weil ich einen Coding-Agenten wie OpenCode damit laufen lasse: Bei kleineren Kontexten kommt es zu häufigen Compactions, was das Arbeiten mühsam macht. Ein größerer Kontext wäre schön, passt aber in meinem Setup nicht mehr in den VRAM. Das Setup ist für einen einzelnen lokalen Arbeitsplatz gedacht, nicht für einen Server, an dem mehrere Nutzer gleichzeitig ihre Anfragen stellen.
Den fertigen Endpoint kann jeder Client ansprechen, der die OpenAI-kompatible API versteht, während die Modelle lokal auf deiner eigenen Maschine laufen und keine Cloud benötigen. Der lange Kontext ist dabei kein […]

code-bude.net

Datenschutz-Übersicht

Diese Website verwendet Cookies, damit wir dir die bestmögliche Benutzererfahrung bieten können. Cookie-Informationen werden in deinem Browser gespeichert und führen Funktionen aus, wie das Wiedererkennen von dir, wenn du auf unsere Website zurückkehrst, und hilft unserem Team zu verstehen, welche Abschnitte der Website für dich am interessantesten und nützlichsten sind.